


技術2課の小林です。
最近Transcribeを触る機会がありました。
そのとき、S3にPUTするとTranscribeが自動実行される構成を考えました。
構成とシナリオ
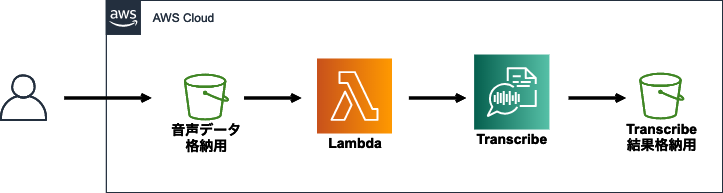
- S3 Bucket
音声データ格納用に音声データを格納 - 1をトリガーにLambdaが起動し、Transcribeが起動する
- 文字起こしの結果がS3 Bucket
Transcribe結果格納用に格納される
構築手順
- S3 Bucketの作成(
音声データ格納用とTranscribe結果格納用)
2, Lambdaの作成
- IAM Role
- AmazonS3FullAccess
- AmazonTranscribeFullAccess
- CloudWatchLogsFullAccess
- トリガー
- 1で作成したS3 Bucket
音声データ格納用を指定
- 1で作成したS3 Bucket
- 関数コード
- コード
- 下記コードを入力
- コード
- 環境変数
- キー
- output_bucket
- 値
- S3 Bucket
Transcribe結果格納用のBucket名を記入
- S3 Bucket
- キー
import boto3
import os
from pathlib import Path

client = boto3.client('transcribe')

def lambda_handler(event, context):
    bucket_name = event['Records'][0]['s3']['bucket']['name']
    object_name = event['Records'][0]['s3']['object']['key']
    file_uri = f'https://{bucket_name}.s3-ap-northeast-1.amazonaws.com/{object_name}'
    job_name = Path(object_name).stem

    client.start_transcription_job(
        TranscriptionJobName=job_name,
        Media={
            'MediaFileUri':file_uri
        },
        MediaFormat='mp3',
        LanguageCode='en-US',
        OutputBucketName= os.environ.get('output_bucket')
    )
あとがき
作成後、S3 Bucket音声データ格納用 に音声ファイルを格納すると 、Transcribe結果格納用に出力結果のjsonファイルと書き込み確認用のオブジェクト .write_access_check_file.temp が出力されます
この構成単体で使うことは少ないかもしれませんが、これを応用して Transcribe結果格納用 bucketにPUTされたことをトリガーに次の処理を実行する、ということができます(私の場合は、Translateとの連携を実施しました)
色々試してみてください
参考URL
- Amazon Transcribe Boto3 (Python SDK) ドキュメント
